노타, AMD GPU·NPU 분리로 응답 52% 단축
최근 30일 조회수 —좋아요 —핵심 요약
노타는 자체 평가에서 AMD 기반 AI 추론 응답 시간을 최대 52% 줄이고 에너지 소비를 31% 절감했다.
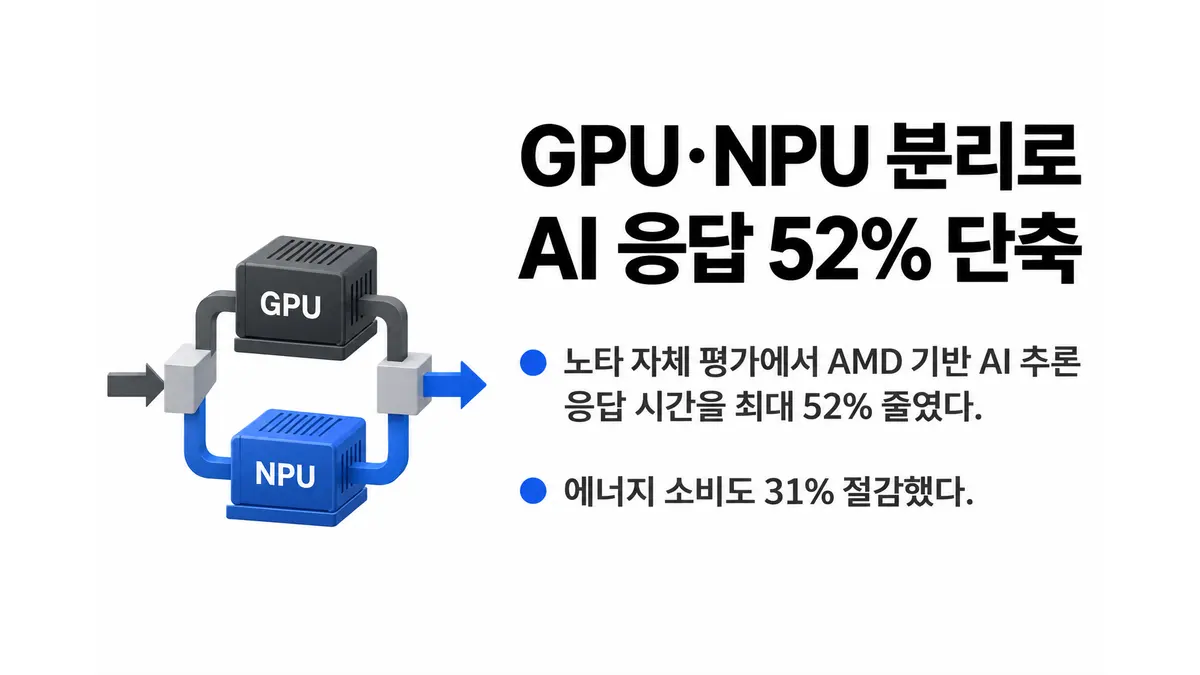
노타가 AMD의 ‘라이젠 AI Max+ 395’ 기반 자체 평가에서 그래픽처리장치(GPU)와 신경망처리장치(NPU)의 추론 작업을 분리해 인공지능(AI) 모델 응답 시간을 최대 52% 단축하고 토큰당 에너지 소비를 31% 줄였다고 9일 발표했다. 이번 성과는 노타가 자체 측정한 결과로, 외부 검증 수치는 제시되지 않았다.1
노타는 입력 정보를 처리하는 ‘프리필’은 NPU에, 답변을 생성하는 ‘디코드’는 GPU에 맡겼다. 두 장치가 같은 모델 가중치를 공유하도록 설계해 중복 메모리 사용도 줄였다. 라마·큐원·파이·미스트랄 등 언어모델을 대상으로 검증한 결과, 기존 AMD 하이브리드 환경보다 메모리 사용량이 1132% 감소했고 NPU 단독 실행과 비교한 답변 생성 속도는 2.53.8배 빨라졌다는 설명이다.
노타는 AI 모델 최적화 플랫폼 넷츠프레소(Netspresso)에 AI 에이전트 기반 기술도 적용했다. AI 에이전트가 모델과 하드웨어 특성을 분석해 최적화 전략을 세우고 성능을 검증·개선하는 방식이다. 회사는 지난 7월 AMD 로보틱스 파트너 네트워크에 합류했으며, 앞으로 AI PC와 로보틱스 분야에서 플랫폼 라이선스 사업을 확대할 계획이다.
Footnotes
-
전자신문, 「노타, AMD 기반 GPU·NPU 추론 최적화…“답변 시간 52% 단축”」 ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- 노타, AMD 기반 GPU·NPU 추론 최적화…“답변 시간 52% 단축” — 전자신문 · 자료: 2026. 11. 9.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.