메타 AI 추론 서비스에 구글 TPU 투입
최근 30일 조회수 —좋아요 —핵심 요약
메타가 파이토치 작업을 재작성하지 않고 구글 TPU에서 구동하는 기술을 실제 AI 추론 서비스에 적용했다.
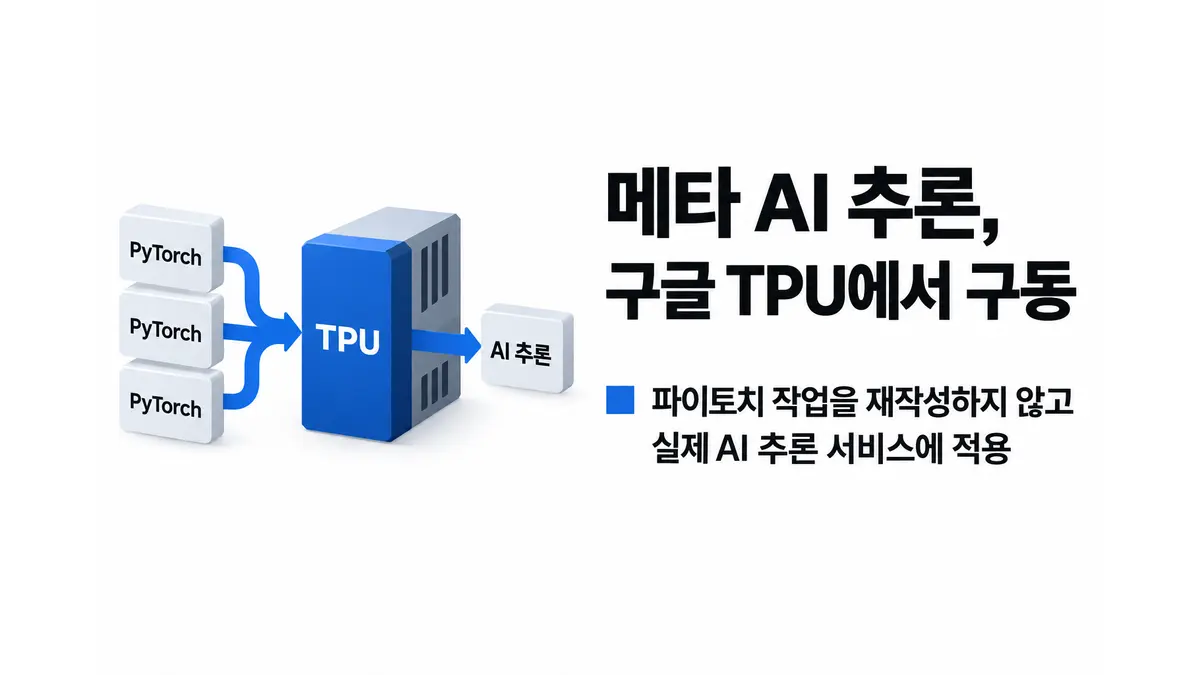
구글의 자체 인공지능(AI) 가속기 TPU가 메타의 실제 AI 추론 서비스에 투입됐다. 톰스하드웨어에 따르면 메타는 구글, SGLang 개발사 래딕스아크(RadixArk)와 공동 개발한 SGLang-TorchTPU를 실제 서비스 환경에서 가동하고 있다.1
핵심은 메타가 주로 쓰는 파이토치(PyTorch) 작업을 큰 폭으로 다시 작성하지 않고 TPU에서 구동할 수 있게 됐다는 점이다. 기존 SGLang과 vLLM은 구글의 JAX 프레임워크를 거쳐야 했지만, 새 버전은 파이토치 네이티브 백엔드를 제공한다. 구글은 vLLM-TorchTPU도 오픈소스로 공개했다. 메타는 단일 하드웨어 아키텍처에 묶일 수 없다며, TorchTPU가 파이토치 작업을 구글 TPU에 배포할 길을 열었다고 설명했다.
성능 수치는 개발에 참여한 업체의 시험 결과라는 한계가 있다. vLLM 개발진이 세운 인퍼랙트(Inferact)는 7세대 아이언우드(Ironwood) TPU 16개로 2조8000억 매개변수 규모의 Kimi K3를 구동해 단일 사용자 기준 초당 700토큰을 넘겼다고 밝혔다. 비교 대상으로 제시한 엔비디아 GB200 16개 환경은 초당 452토큰이었다. 다만 TPU 시험에는 소형 초안 모델로 생성을 가속하는 추측 디코딩이 적용돼 단순한 칩 간 성능 비교로 보기는 어렵다.
메타가 사용하는 TPU의 위치와 조달 방식도 공개되지 않았다. 앞서 클라우드 임대와 2027년 직접 구매 가능성이 보도됐지만, 이번 발표는 구매 여부를 확인하지 않았다. 따라서 외부 고객의 생산 서비스 투입은 확인됐으나 TPU 판매가 실제로 이뤄졌는지는 아직 불분명하다.
Footnotes
-
Tom’s Hardware, “Google’s TPUs for AI workloads now run in Meta’s data centers” ↩
읽기 목록은 이 브라우저에 저장됩니다.
출처
- Google’s TPUs for AI workloads now run in Meta's data centers — Tom's Hardware · 자료: 2026. 10. 22.
이 글은 위 출처를 근거로 자동 생성된 뒤 발행됐습니다. 원문을 함께 확인해 주세요. 교차 보도 없이 단독 출처로 작성됐습니다.